体育录像复盘基准测试
哪个编程 agent 和视觉模型最会看体育录像?用程序画的训练视频来测。每次运行都和工具画进视频里的真实值比对打分,所以每个数字都是测出来的,不是评出来的。
主要结论:推理 effort 改变了什么
静帧赛道:只看静帧,不能跑代码。每次运行都用一个新的、没见过的种子重新画 svc-bench-3。
- Haiku 5.5 Claude Code
默认 0.198 (n=1) · high 0.564 (n=1) - Opus 5.5 Claude Code
默认 0.997 (n=2, 0.994–1.000) · low 0.778 (n=1) - Sonnet 5.5 Claude Code
默认 0.419 (n=2, 0.413–0.426) · high 0.931 (n=4, 0.856–0.994) · max:没有回答,超时,记 0 分(n=2)
分数 = 超出盲猜: 0 = 不比不看视频的盲猜强,1 = 满分。
共 13 次运行,7 个设置里有 3 个只跑了一次,全部由写这个工具的 mariusDing 自己跑。 图表和每次运行
用你的 agent 重跑 (换模型就改 --model;用默认 effort 就去掉 --effort)
uv tool install git+https://github.com/mariusDing/sports-video-coach@74b517fc410944fefeac2979810656ed77fb8f1a
sports-video-coach bench run --agent claude --model claude-sonnet-5-5 --effort high --seed --suite svc-bench-3 --track frames它属于 sports-video-coach,一个免费的 MIT 工具:你的编程 agent 看你自己的运动视频,给你写一页带片段和练习的教练复盘。 看一个示例教练复盘页。
结论速读:effort 改变了什么、盲猜基线、本地模型、费用。
- 套件 svc-bench-3, svc-bench-2, svc-bench-1
- 37 次运行
- 只用测出来的真实值
- 最近一次运行 2026-10-25
自己数一数
svc-bench-3 里的 juggle-touches 题:和每个参赛者拿到的是同一段 29.76 秒视频,上面没有画答案。看完、数好、填上你的数字,页面才会显示真实值和每个模型的回答。
参赛者拿到的题目(译自英文原文):
两名球员各用一只脚颠一模一样的黄色小球,侧面视角:左边是红色球员,右边是橙红色球员。数左边(红色)球员的触球次数:他的脚每碰到自己的球一次算一次。快速连续两触(球从脚上稍微弹起,马上又被碰到)算两次。球落地反弹不算触球。右边球员的触球不算。镜头是手持的。
数完了?点开看真实值和每个模型的回答
真实值:47 次
- Opus 5.5 静帧赛道47, 47
- Codex · gpt-6-astra 静帧赛道47
- Haiku 5.5 静帧赛道60
- Sonnet 5.5 静帧赛道60, 75
- Fable 5.1 静帧赛道–, 49
- Ollama · qwen3-vl:4b-instruct-q4_K_M 静帧赛道100
- Sonnet 5.5 代码赛道46, 51
- 盲猜(没看视频)5
基准怎么给次数题打分:1 - |误差| / 真实值,最低为 0。
静帧赛道:模型只看这段视频的静帧(每 0.08 秒一张),不能运行代码。代码赛道:它可以自己写追踪程序并运行。盲猜照抄题目里的示例答案。
回答照搬 benchmark/results 里存的,每次运行一个;答对的是绿色;– = 这次运行没有作答。
信之前先看:怀疑的人最先会问的 11 件事
- 谁跑的:全部 37 次运行都由这个工具的作者 mariusDing 提交;还没有外部提交的运行。
- 自带配置:37 次运行中有 8 次在设置栏注明加载了提交者自己的 agent 配置(CLAUDE.md、AGENTS.md 或 Codex 配置)。
- 样本量:27 个参赛者(按套件和赛道分)中有 19 个只跑了一次。设置完全相同的两次运行,超出盲猜分最多相差 0.224(claude-sonnet-5-5,svc-bench-3,静帧赛道):比这小的差距当作噪声看。到时限被终止的运行记 0 分,会让该参赛者的范围更宽。
- 设置:没有统一。每一行按它设置栏写的 effort 和参数运行。
- 真实值:视频是工具按数字画出来的,所以真实值是精确的。没有人工标注,也没有评审模型。
- 真实值是公开的:公开的套件和真实值都在开源包里,模型可能在训练时见过;37 次运行中有 15 次在运行时用新种子(
--seed)重新生成 svc-bench-3,这能减少背下公开答案的影响,但证明不了任何关于训练数据的事。agent 的文件夹里从来没有这份答案;结果文件和本页有,所以公开过的种子就作废了。 - 套件设计:svc-bench-2 和 svc-bench-3 都是在有模型把前一个套件做到 1.0 之后才做的,所以作者当时知道哪些模型已经做满分。
- 提示词:
bench run每个赛道发一段固定文本,所有模型都一样;只确定 Claude Code 静帧那几行用的是它。见完整提示词。 - 超出盲猜:起点是照抄题目示例答案的盲猜,不是随机猜。光靠这种猜法,单道题最高就能拿 0.83(shot-outcomes-hard)。
- 证据:37 次运行中有 37 次附了对话记录(在证据栏):agent 打开的每个文件、运行的每条命令和最后的回复,图片、用户目录和像密钥的字符串都已去掉。任何人都能读;CI 会重新给答案打分,但不读这些记录。
- 用时和费用:每张表都有;37 次运行中 37 次记录了用时,24 次记录了费用。
排行榜
代码赛道:agent 可以自己写追踪程序并运行。静帧赛道(agent 只用眼睛看)在下面。 设置栏照搬结果文件里的英文原文。
svc-bench-3
眼力:四段程序画的视频,事件小、短或被挡住:640x360 画面里半径 5 px 的球,16 px 宽的远处篮筐上半径 3 px 的球,相隔 0.24 s 的两次触球,挡在关键时刻前面的横幅和防守人,传球假动作,以及答案几乎一样的干扰项(第二个颠球的人、第二对传球的人、节奏相近的远处小船)。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code | claude-sonnet-5-5 | runner's own agent config (--use-my-config) | 1 | 0.995 | 0.994 | - | 214 s | $0.61 |
| 2 | Claude Code | claude-sonnet-5-5 | clean-room: no user config | 1 | 0.958 | 0.951 | - | 264 s | $0.67 |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | juggle-touches | far-hoop-shots | pass-releases | stroke-rate | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 | claude-sonnet-5-5 | runner's own agent config (--use-my-config) | 0.98 | 1.00 | 1.00 | 1.00 | 0.995 | 0.994 | 214 s | $0.61 | 2026-10-24 | mariusDing | 记录 |
| 2 | Claude Code 2.1.310 | claude-sonnet-5-5 | clean-room: no user config | 0.92 | 1.00 | 0.92 | 1.00 | 0.958 | 0.951 | 264 s | $0.67 | 2026-10-24 | mariusDing | 记录 |
| 基线 | 基线: blind baseline (没看视频) | - | answers copied from the TASKS.md examples; no video or still seen | 0.11 | 0.50 | 0.17 | 0.55 | 0.331 | 0.000 | - | - | 2026-10-24 | - | - |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
juggle-touches次数 · count
真实值: 47
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-sonnet-5-5 第 1 次 | 46 | 0.98 | 少了 1 |
| claude-sonnet-5-5 第 2 次 | 51 | 0.92 | 多了 4 |
far-hoop-shots结果 · outcomes
真实值: 进 6,不进 6: M x M x x M M x x M x M(M = 进)
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-sonnet-5-5 第 1 次 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 2 次 | 进 6,不进 6 | 1.00 | 完全正确 |
pass-releases时间点 · timestamps
真实值: 12 次: 1, 3, 4.48, 5.28, 7.16, 9.48, 11.48, 12.16, 14.56, 15.84, 17.76, 19.32 s
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-sonnet-5-5 第 1 次 | 12 次 | 1.00 | 全部在 0.5 s 内 |
| claude-sonnet-5-5 第 2 次 | 11 次 | 0.92 | 12 个中有 1 个不在 0.5 s 内(在 5.28 s) |
stroke-rate比率 · rate
真实值: 33.92
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-sonnet-5-5 第 1 次 | 34.1 | 1.00 | 偏高 0.5% |
| claude-sonnet-5-5 第 2 次 | 33.9 | 1.00 | 偏低 0.1% |
svc-bench-2
难:五段程序画的视频,手持镜头,有长得像的干扰项(第二个球、两只一模一样的脚、一个抢篮板的人)、按规则定义的事件和噪点。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1= | Claude Code | claude-sonnet-5-5 | user CLAUDE.md loaded | 1 | 1.000 | 1.000 | - | 339 s | $1.08 |
| 1= | Codex | gpt-6-astra | reasoning effort xhigh, user config loaded | 1 | 1.000 | 1.000 | - | 492 s | - |
| 3 | Claude Code | claude-opus-5-5 | user CLAUDE.md loaded | 1 | 0.960 | 0.956 | - | 262 s | $1.40 |
| 4 | OpenCode | opencode/deepseek-v4.1-flash-free | preset, run by the maintainer (--agent opencode); runner's own config; fresh OpenCode install, empty config, no account (free OpenCode Zen model); OpenCode Zen's free usage limit was reached about 1130 s in, with answers.json still unwritten | 1 | 0.000 | 0.000 | - | 1200 s | - |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | dribble-count | squat-reps | cadence-change | cone-touches-pan | shot-outcomes-hard | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 | claude-sonnet-5-5 | user CLAUDE.md loaded | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 339 s | $1.08 | 2026-10-24 | mariusDing | 记录 |
| 2 | Codex 0.159.3 | gpt-6-astra | reasoning effort xhigh, user config loaded | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 492 s | - | 2026-10-24 | mariusDing | 记录 |
| 3 | Claude Code 2.1.310 | claude-opus-5-5 | user CLAUDE.md loaded | 1.00 | 1.00 | 1.00 | 0.80 | 1.00 | 0.960 | 0.956 | 262 s | $1.40 | 2026-10-24 | mariusDing | 记录 |
| 4 | OpenCode 1.19.4 | opencode/deepseek-v4.1-flash-free | preset, run by the maintainer (--agent opencode); runner's own config; fresh OpenCode install, empty config, no account (free OpenCode Zen model); OpenCode Zen's free usage limit was reached about 1130 s in, with answers.json still unwritten | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.000 | 0.000 | 1200 s | - | 2026-10-25 | mariusDing | 记录 |
| 基线 | 基线: blind baseline (没看视频) | - | answers copied from the TASKS.md examples; no video or still seen | 0.09 | 0.62 | 0.14 | 0.09 | 0.83 | 0.356 | 0.000 | - | - | 2026-10-24 | - | - |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
dribble-count次数 · count
真实值: 56
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 56 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 56 | 1.00 | 完全正确 |
| gpt-6-astra | 56 | 1.00 | 完全正确 |
| opencode/deepseek-v4.1-flash-free | - | 0.00 | 没有作答 |
squat-reps次数 · count
真实值: 8
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 8 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 8 | 1.00 | 完全正确 |
| gpt-6-astra | 8 | 1.00 | 完全正确 |
| opencode/deepseek-v4.1-flash-free | - | 0.00 | 没有作答 |
cadence-change比率 · rate
真实值: 182.186
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 182.2 | 1.00 | 偏高 0.0% |
| claude-sonnet-5-5 | 182 | 1.00 | 偏低 0.1% |
| gpt-6-astra | 182.2 | 1.00 | 偏高 0.0% |
| opencode/deepseek-v4.1-flash-free | - | 0.00 | 没有作答 |
cone-touches-pan时间点 · timestamps
真实值: 10 次: 3.6, 7.6, 10.6, 11, 11.4, 14.8, 19.6, 22, 23.2, 26.6 s
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 8 次 | 0.80 | 10 个中有 2 个不在 0.5 s 内(在 7.6 s,19.6 s) |
| claude-sonnet-5-5 | 10 次 | 1.00 | 全部在 0.5 s 内 |
| gpt-6-astra | 10 次 | 1.00 | 全部在 0.5 s 内 |
| opencode/deepseek-v4.1-flash-free | - | 0.00 | 没有作答 |
shot-outcomes-hard结果 · outcomes
真实值: 进 6,不进 6: M x x M M x M x M x M x(M = 进)
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 进 6,不进 6 | 1.00 | 完全正确 |
| gpt-6-astra | 进 6,不进 6 | 1.00 | 完全正确 |
| opencode/deepseek-v4.1-flash-free | - | 0.00 | 没有作答 |
svc-bench-1
四段很短的程序画视频,固定机位。在这个赛道上已经饱和:全部 3 次运行都是 1.0,排不出高低。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1= | Claude Code | claude-opus-5-5 | claude -p, default effort, 1M context, user CLAUDE.md loaded | 1 | 1.000 | 1.000 | - | 87 s | - |
| 1= | Claude Code | claude-sonnet-5-5 | claude -p, default effort, user CLAUDE.md loaded; cost 0.33 USD | 1 | 1.000 | 1.000 | - | 55 s | - |
| 1= | Codex | - | codex exec, default settings, user config loaded (model not recorded in the run log) | 1 | 1.000 | 1.000 | - | 218 s | - |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | jump-count | stroke-rate | cone-touches | shot-outcomes | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 | claude-opus-5-5 | claude -p, default effort, 1M context, user CLAUDE.md loaded | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 87 s | - | 2026-10-24 | mariusDing | 记录 |
| 2 | Claude Code 2.1.310 | claude-sonnet-5-5 | claude -p, default effort, user CLAUDE.md loaded; cost 0.33 USD | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 55 s | - | 2026-10-24 | mariusDing | 记录 |
| 3 | Codex 0.159.3 | - | codex exec, default settings, user config loaded (model not recorded in the run log) | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 218 s | - | 2026-10-24 | mariusDing | 记录 |
| 基线 | 基线: blind baseline (没看视频) | - | answers copied from the TASKS.md examples; no video or still seen | 0.39 | 0.00 | 0.11 | 0.80 | 0.324 | 0.000 | - | - | 2026-10-24 | - | - |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
jump-count次数 · count
真实值: 13
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 13 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 13 | 1.00 | 完全正确 |
| Codex | 13 | 1.00 | 完全正确 |
stroke-rate比率 · rate
真实值: 42
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 42 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 42 | 1.00 | 完全正确 |
| Codex | 42 | 1.00 | 完全正确 |
cone-touches时间点 · timestamps
真实值: 7 次: 3.2, 5.4, 6.8, 10.4, 12.2, 14.8, 17.4 s
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 7 次 | 1.00 | 全部在 0.5 s 内 |
| claude-sonnet-5-5 | 7 次 | 1.00 | 全部在 0.5 s 内 |
| Codex | 7 次 | 1.00 | 全部在 0.5 s 内 |
shot-outcomes结果 · outcomes
真实值: 进 5,不进 5: M x M M x x M x M x(M = 进)
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 进 5,不进 5 | 1.00 | 完全正确 |
| claude-sonnet-5-5 | 进 5,不进 5 | 1.00 | 完全正确 |
| Codex | 进 5,不进 5 | 1.00 | 完全正确 |
静帧赛道(眼力)
静帧赛道:agent 只能看每段视频的静帧(拼成的缩略图,每张下面标着时间),没有能运行代码的工具,只能用眼睛看。视频、真实值和打分方式都和代码赛道相同。分数衡量的是模型看到了什么、看得多仔细:只翻几张静帧的模型是在猜,而猜也可能拿高分。
一条命令重跑:准备套件,以无界面模式运行不带代码工具的 Claude Code(或用 --agent cmd --cmd "... {prompt}" 运行任意 CLI),再给答案打分。
sports-video-coach bench run --agent claude --model <model> --suite svc-bench-3 --track frames不想在本机安装:在 GitHub Codespaces 中打开 里已装好 uv、ffmpeg 以及 Claude Code 和 Codex CLI,用的是你自己 GitHub 账号的免费时长。在里面登录你的 agent,再在命令前面加上 uv run。
其他 agent:先准备好静帧,让它用眼睛填好 bench-frames/answers.json,再用 bench score bench-frames 打分。
sports-video-coach bench prepare --out bench-frames --suite svc-bench-3 --track framessvc-bench-3
眼力:四段程序画的视频,事件小、短或被挡住:640x360 画面里半径 5 px 的球,16 px 宽的远处篮筐上半径 3 px 的球,相隔 0.24 s 的两次触球,挡在关键时刻前面的横幅和防守人,传球假动作,以及答案几乎一样的干扰项(第二个颠球的人、第二对传球的人、节奏相近的远处小船)。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 1.000 | 1.000 | 1.000–1.000 | 494 s | $3.72 |
| 2 | Codex | gpt-6-astra | frames track; codex exec -s read-only, shell/exec/code-mode features disabled, sheets attached with -i; reasoning effort xhigh (user config) | 1 | 0.862 | 0.727 | - | 766 s | - |
| 3 | Claude Code | claude-fable-5-1 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 0.494 | 0.494 | 0.000–0.988 | 1673 s | $19.23 (2 次中有 1 次) |
| 4 | Claude Code | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 0.526 | 0.385 | 0.273–0.497 | 40 s | $0.14 |
| 5 | Claude Code | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1 | 0.585 | 0.333 | - | 136 s | $0.04 |
| 6 | Ollama | qwen3-vl:4b-instruct-q4_K_M | frames track; OpenAI-compatible chat completions on Ollama 0.40.10, weights Q4_K_M, 4.0B; one request per task (4 requests, 11-27 contact sheets each as base64 JPEG, sheets as drawn (1280 px on the longer side)), the task's section of TASKS.md and the rules in the prompt, no full-size stills, no tools; temperature 0, max_tokens 4096; server: OLLAMA_CONTEXT_LENGTH=32768, flash attention, KV cache q8_0; RTX 3070 8 GB | 1 | 0.125 | 0.000 | - | 260 s | - |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | juggle-touches | far-hoop-shots | pass-releases | stroke-rate | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 489 s | $3.91 | 2026-10-24 | mariusDing | 记录 |
| 2 | Claude Code 2.1.310 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 500 s | $3.52 | 2026-10-24 | mariusDing | 记录 |
| 3 | Claude Code 2.1.310 | claude-fable-5-1 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.96 | 1.00 | 1.00 | 1.00 | 0.989 | 0.988 | 1645 s | $19.23 | 2026-10-24 | mariusDing | 记录 |
| 4 | Codex 0.159.3 | gpt-6-astra | frames track; codex exec -s read-only, shell/exec/code-mode features disabled, sheets attached with -i; reasoning effort xhigh (user config) | 1.00 | 1.00 | 0.92 | 0.53 | 0.862 | 0.727 | 766 s | - | 2026-10-24 | mariusDing | 记录 |
| 5 | Claude Code 2.1.310 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.72 | 0.75 | 0.83 | 0.14 | 0.612 | 0.497 | 65 s | $0.23 | 2026-10-24 | mariusDing | 记录 |
| 6 | Claude Code 2.1.310 | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.72 | 0.58 | 0.56 | 0.47 | 0.585 | 0.333 | 136 s | $0.04 | 2026-10-24 | mariusDing | 记录 |
| 7 | Claude Code 2.1.310 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.40 | 0.42 | 0.80 | 0.14 | 0.441 | 0.273 | 16 s | $0.06 | 2026-10-24 | mariusDing | 记录 |
| 8 | Ollama 0.40.10 | qwen3-vl:4b-instruct-q4_K_M | frames track; OpenAI-compatible chat completions on Ollama 0.40.10, weights Q4_K_M, 4.0B; one request per task (4 requests, 11-27 contact sheets each as base64 JPEG, sheets as drawn (1280 px on the longer side)), the task's section of TASKS.md and the rules in the prompt, no full-size stills, no tools; temperature 0, max_tokens 4096; server: OLLAMA_CONTEXT_LENGTH=32768, flash attention, KV cache q8_0; RTX 3070 8 GB | 0.00 | 0.50 | 0.00 | 0.00 | 0.125 | 0.000 | 260 s | - | 2026-10-25 | mariusDing | 记录 |
| 9 | Claude Code 2.1.310 | claude-fable-5-1 | frames track; claude -p --restricted --safe-mode --tools Read; default effort; killed at the 1700 s time limit before writing answers (read 548 stills) | 0.00 | 0.00 | 0.00 | 0.00 | 0.000 | 0.000 | 1700 s | - | 2026-10-24 | mariusDing | 记录 |
| 基线 | 基线: blind baseline (没看视频) | - | answers copied from the TASKS.md examples; no video or still seen | 0.11 | 0.50 | 0.17 | 0.55 | 0.331 | 0.000 | - | - | 2026-10-24 | - | - |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
juggle-touches次数 · count
真实值: 47
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-fable-5-1 第 1 次 | - | 0.00 | 没有作答 |
| claude-fable-5-1 第 2 次 | 49 | 0.96 | 多了 2 |
| claude-haiku-5-5 | 60 | 0.72 | 多了 13 |
| claude-opus-5-5 第 1 次 | 47 | 1.00 | 完全正确 |
| claude-opus-5-5 第 2 次 | 47 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 1 次 | 60 | 0.72 | 多了 13 |
| claude-sonnet-5-5 第 2 次 | 75 | 0.40 | 多了 28 |
| gpt-6-astra | 47 | 1.00 | 完全正确 |
| qwen3-vl:4b-instruct-q4_K_M | 100 | 0.00 | 多了 53 |
far-hoop-shots结果 · outcomes
真实值: 进 6,不进 6: M x M x x M M x x M x M(M = 进)
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-fable-5-1 第 1 次 | - | 0.00 | 没有作答 |
| claude-fable-5-1 第 2 次 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-haiku-5-5 | 进 5,不进 7 | 0.58 | 12 个中错 5 个(第 3 个答成 missed,第 4 个答成 made,第 6 个答成 missed,第 7 个答成 missed 等,另有 1 个) |
| claude-opus-5-5 第 1 次 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-opus-5-5 第 2 次 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 1 次 | 进 7,不进 5 | 0.75 | 12 个中错 3 个(第 5 个答成 made,第 7 个答成 missed,第 8 个答成 made) |
| claude-sonnet-5-5 第 2 次 | 进 7,不进 5 | 0.42 | 12 个中错 7 个(第 4 个答成 made,第 7 个答成 missed,第 8 个答成 made,第 9 个答成 made 等,另有 3 个) |
| gpt-6-astra | 进 6,不进 6 | 1.00 | 完全正确 |
| qwen3-vl:4b-instruct-q4_K_M | 进 6,不进 6 | 0.50 | 12 个中错 6 个(第 5 个答成 made,第 6 个答成 missed,第 9 个答成 made,第 10 个答成 missed 等,另有 2 个) |
pass-releases时间点 · timestamps
真实值: 12 次: 1, 3, 4.48, 5.28, 7.16, 9.48, 11.48, 12.16, 14.56, 15.84, 17.76, 19.32 s
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-fable-5-1 第 1 次 | - | 0.00 | 没有作答 |
| claude-fable-5-1 第 2 次 | 12 次 | 1.00 | 全部在 0.5 s 内 |
| claude-haiku-5-5 | 7 次 | 0.56 | 12 个中有 6 个不在 0.5 s 内(在 3 s,9.48 s,11.48 s,12.16 s 等,另有 2 个);1 个对不上(在 16.9 s) |
| claude-opus-5-5 第 1 次 | 12 次 | 1.00 | 全部在 0.5 s 内 |
| claude-opus-5-5 第 2 次 | 12 次 | 1.00 | 全部在 0.5 s 内 |
| claude-sonnet-5-5 第 1 次 | 10 次 | 0.83 | 12 个中有 2 个不在 0.5 s 内(在 12.16 s,15.84 s) |
| claude-sonnet-5-5 第 2 次 | 10 次 | 0.80 | 12 个中有 4 个不在 0.5 s 内(在 4.48 s,12.16 s,15.84 s,17.76 s);2 个对不上(在 13 s,17 s) |
| gpt-6-astra | 13 次 | 0.92 | 1 个对不上(在 7.76 s) |
| qwen3-vl:4b-instruct-q4_K_M | - | 0.00 | 没有作答 |
stroke-rate比率 · rate
真实值: 33.92
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-fable-5-1 第 1 次 | - | 0.00 | 没有作答 |
| claude-fable-5-1 第 2 次 | 33.9 | 1.00 | 偏低 0.1% |
| claude-haiku-5-5 | 30 | 0.47 | 偏低 11.6% |
| claude-opus-5-5 第 1 次 | 33.9 | 1.00 | 偏低 0.1% |
| claude-opus-5-5 第 2 次 | 33.9 | 1.00 | 偏低 0.1% |
| claude-sonnet-5-5 第 1 次 | 28 | 0.14 | 偏低 17.5% |
| claude-sonnet-5-5 第 2 次 | 28 | 0.14 | 偏低 17.5% |
| gpt-6-astra | 37.5 | 0.53 | 偏高 10.6% |
| qwen3-vl:4b-instruct-q4_K_M | - | 0.00 | 没有作答 |
svc-bench-2
难:五段程序画的视频,手持镜头,有长得像的干扰项(第二个球、两只一模一样的脚、一个抢篮板的人)、按规则定义的事件和噪点。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1= | Claude Code | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1 | 1.000 | 1.000 | - | 522 s | $3.04 |
| 1= | Codex | gpt-6-astra | frames track; codex exec -s read-only, shell/exec/code-mode features disabled, sheets attached with -i; reasoning effort xhigh (user config); the user's global Codex AGENTS.md was loaded (it replied in Chinese) | 1 | 1.000 | 1.000 | - | 585 s | - |
| 3 | Claude Code | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 0.701 | 0.512 | 0.460–0.564 | 45 s | $0.15 |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | dribble-count | squat-reps | cadence-change | cone-touches-pan | shot-outcomes-hard | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 522 s | $3.04 | 2026-10-24 | mariusDing | 记录 |
| 2 | Codex 0.159.3 | gpt-6-astra | frames track; codex exec -s read-only, shell/exec/code-mode features disabled, sheets attached with -i; reasoning effort xhigh (user config); the user's global Codex AGENTS.md was loaded (it replied in Chinese) | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 585 s | - | 2026-10-24 | mariusDing | 记录 |
| 3 | Claude Code 2.1.310 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.80 | 1.00 | 0.74 | 0.40 | 0.83 | 0.755 | 0.564 | 77 s | $0.24 | 2026-10-24 | mariusDing | 记录 |
| 4 | Claude Code 2.1.310 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.80 | 0.88 | 0.74 | 0.23 | 0.58 | 0.646 | 0.460 | 12 s | $0.05 | 2026-10-24 | mariusDing | 记录 |
| 基线 | 基线: blind baseline (没看视频) | - | answers copied from the TASKS.md examples; no video or still seen | 0.09 | 0.62 | 0.14 | 0.09 | 0.83 | 0.356 | 0.000 | - | - | 2026-10-24 | - | - |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
dribble-count次数 · count
真实值: 56
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 56 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 1 次 | 45 | 0.80 | 少了 11 |
| claude-sonnet-5-5 第 2 次 | 45 | 0.80 | 少了 11 |
| gpt-6-astra | 56 | 1.00 | 完全正确 |
squat-reps次数 · count
真实值: 8
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 8 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 1 次 | 8 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 2 次 | 7 | 0.88 | 少了 1 |
| gpt-6-astra | 8 | 1.00 | 完全正确 |
cadence-change比率 · rate
真实值: 182.186
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 182.2 | 1.00 | 偏高 0.0% |
| claude-sonnet-5-5 第 1 次 | 170 | 0.74 | 偏低 6.7% |
| claude-sonnet-5-5 第 2 次 | 170 | 0.74 | 偏低 6.7% |
| gpt-6-astra | 182 | 1.00 | 偏低 0.1% |
cone-touches-pan时间点 · timestamps
真实值: 10 次: 3.6, 7.6, 10.6, 11, 11.4, 14.8, 19.6, 22, 23.2, 26.6 s
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 10 次 | 1.00 | 全部在 0.5 s 内 |
| claude-sonnet-5-5 第 1 次 | 4 次 | 0.40 | 10 个中有 6 个不在 0.5 s 内(在 3.6 s,10.6 s,11 s,11.4 s 等,另有 2 个) |
| claude-sonnet-5-5 第 2 次 | 4 次 | 0.23 | 10 个中有 10 个不在 0.5 s 内(在 3.6 s,7.6 s,10.6 s,11 s 等,另有 6 个);4 个对不上(在 6 s,12 s,18 s,24 s) |
| gpt-6-astra | 10 次 | 1.00 | 全部在 0.5 s 内 |
shot-outcomes-hard结果 · outcomes
真实值: 进 6,不进 6: M x x M M x M x M x M x(M = 进)
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-opus-5-5 | 进 6,不进 6 | 1.00 | 完全正确 |
| claude-sonnet-5-5 第 1 次 | 进 6,不进 6 | 0.83 | 12 个中错 2 个(第 3 个答成 made,第 4 个答成 missed) |
| claude-sonnet-5-5 第 2 次 | 进 7,不进 5 | 0.58 | 12 个中错 5 个(第 3 个答成 made,第 5 个答成 missed,第 6 个答成 made,第 7 个答成 missed 等,另有 1 个) |
| gpt-6-astra | 进 6,不进 6 | 1.00 | 完全正确 |
svc-bench-3-fresh
新种子:每次运行都按结果文件里的种子(`--seed`)重新画一遍 svc-bench-3,场景和陷阱种类不变,但次数、结果、时间和节奏都是新的。agent 的文件夹里从来没有答案;工具按种子重建答案来打分、核对每一行,并在下面展示,所以公开过的种子就作废了。每次运行的基线是它自己那个种子上的盲猜基线。
effort 改变了什么
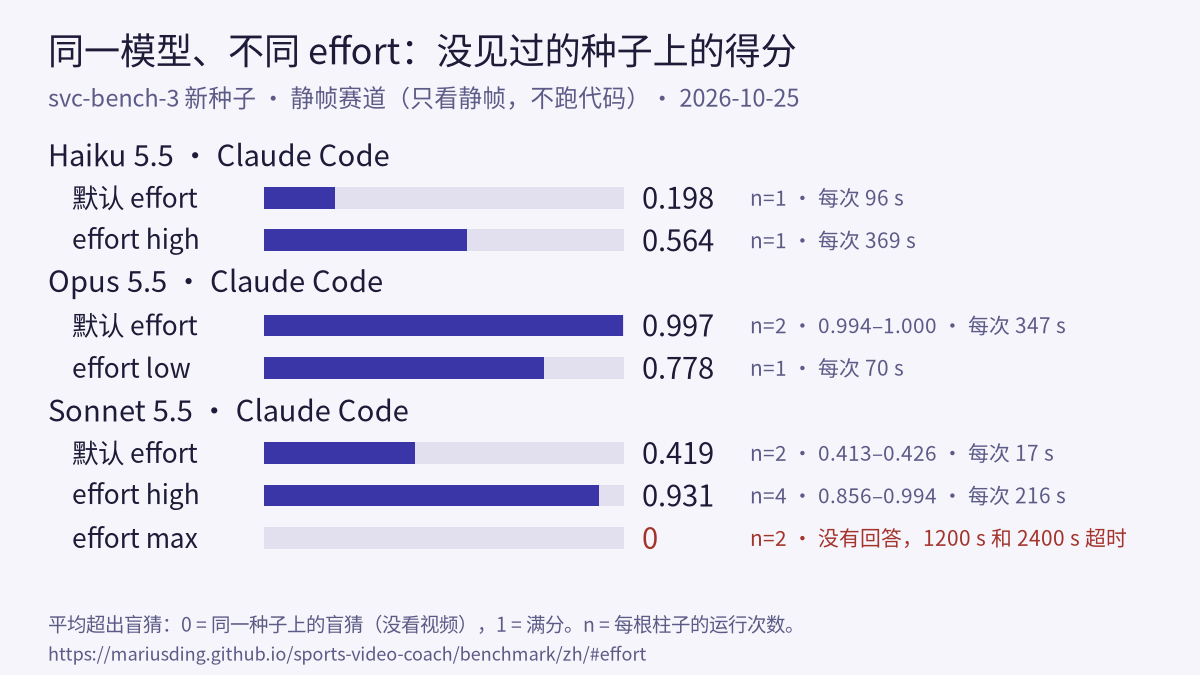
同一个模型,同一类题(每次运行都用新种子重新生成 svc-bench-3,只看静帧用眼睛判断);只改了 effort 设置。平均超出盲猜:
- Haiku 5.5 · Claude Code
- 默认 effort:0.198(1 次运行,96 s)
- effort high:0.564(1 次运行,369 s)
- Opus 5.5 · Claude Code
- 默认 effort:平均 0.997,范围 0.994–1.000(2 次运行,每次 347 s)
- effort low:0.778(1 次运行,70 s)
- Sonnet 5.5 · Claude Code
- 默认 effort:平均 0.419,范围 0.413–0.426(2 次运行,每次 17 s)
- effort high:平均 0.931,范围 0.856–0.994(4 次运行,每次 216 s)
- effort max:没有回答,到时限(1200 s 和 2400 s)被终止,记 0 分(2 次运行)
除非标了 n,每个设置只跑了一次,各用自己的种子:这是测出来的差别,不是方差估计。默认 = 没加 effort 参数(用 CLI 自己的默认值)。每次运行都在下面的榜上有一行。
汇总
| # | Agent | 模型 | 设置 | 次数 (n) | 平均总分 | 平均超出盲猜 | 范围 | 平均用时 | 平均费用 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | Codex | gpt-6-astra | Codex: runner's own config; not isolated, so credentials stay where they are; frames track; codex exec -s read-only, shell/exec/code-mode and other tool features disabled, web search off, sheets attached with -i; beyond that tool restriction is by prompt only (the transcript shows every command it ran); reasoning effort xhigh | 1 | 1.000 | 1.000 | - | 514 s | - |
| 2 | Claude Code | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 0.997 | 0.997 | 0.994–1.000 | 347 s | $2.55 |
| 3 | Claude Code | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 4 | 0.940 | 0.931 | 0.856–0.994 | 216 s | $0.84 |
| 4 | Claude Code | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort low | 1 | 0.879 | 0.778 | - | 70 s | $0.45 |
| 5 | Claude Code | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 1 | 0.698 | 0.564 | - | 369 s | $0.32 |
| 6 | Claude Code | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 2 | 0.543 | 0.419 | 0.413–0.426 | 17 s | $0.06 |
| 7 | Claude Code | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1 | 0.440 | 0.198 | - | 96 s | $0.06 |
| 8 | Ollama | qwen3-vl:4b-instruct-q4_K_M | frames track; OpenAI-compatible chat completions on Ollama 0.40.10, weights Q4_K_M, 4.0B; one request per task (4 requests, 11-30 contact sheets each as base64 JPEG, sheets as drawn (1280 px on the longer side)), the task's section of TASKS.md and the rules in the prompt, no full-size stills, no tools; temperature 0, max_tokens 4096; server: OLLAMA_CONTEXT_LENGTH=40960, flash attention, KV cache q8_0; RTX 3070 8 GB | 1 | 0.077 | 0.000 | - | 621 s | - |
| 9 | Claude Code | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort max | 2 | 0.000 | 0.000 | 0.000–0.000 | 1801 s | - |
按平均超出盲猜排序;“=” 表示并列。n = 同一 agent、模型和设置的运行次数;范围 = 这些运行的超出盲猜总分从最低到最高(只跑一次时为短横)。设置只多一条备注的运行(比如到时限被终止)算在同一个参赛者里。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。
每次运行
| # | Agent | 模型 | 设置 | juggle-touches | far-hoop-shots | pass-releases | stroke-rate | 总分 | 超出盲猜 | 用时 | 费用 | 日期 | 提交者 | 证据 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Claude Code 2.1.310 种子 613104018 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 378 s | $2.77 | 2026-10-25 | mariusDing | 记录 |
| 2 | Codex 0.159.3 种子 911623366 | gpt-6-astra | Codex: runner's own config; not isolated, so credentials stay where they are; frames track; codex exec -s read-only, shell/exec/code-mode and other tool features disabled, web search off, sheets attached with -i; beyond that tool restriction is by prompt only (the transcript shows every command it ran); reasoning effort xhigh | 1.00 | 1.00 | 1.00 | 1.00 | 1.000 | 1.000 | 514 s | - | 2026-10-25 | mariusDing | 记录 |
| 3 | Claude Code 2.1.310 种子 208632171 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 0.98 | 1.00 | 1.00 | 1.00 | 0.995 | 0.994 | 256 s | $0.94 | 2026-10-25 | mariusDing | 记录 |
| 4 | Claude Code 2.1.310 种子 205159368 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.98 | 1.00 | 1.00 | 1.00 | 0.994 | 0.994 | 317 s | $2.32 | 2026-10-25 | mariusDing | 记录 |
| 5 | Claude Code 2.1.310 种子 395804731 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 0.98 | 1.00 | 0.92 | 1.00 | 0.974 | 0.969 | 165 s | $0.70 | 2026-10-25 | mariusDing | 记录 |
| 6 | Claude Code 2.1.310 种子 288038083 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 0.67 | 1.00 | 1.00 | 1.00 | 0.917 | 0.906 | 257 s | $0.99 | 2026-10-25 | mariusDing | 记录 |
| 7 | Claude Code 2.1.310 种子 959964891 | claude-opus-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort low | 0.98 | 0.54 | 1.00 | 1.00 | 0.879 | 0.778 | 70 s | $0.45 | 2026-10-25 | mariusDing | 记录 |
| 8 | Claude Code 2.1.310 种子 633675701 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 0.50 | 1.00 | 1.00 | 1.00 | 0.875 | 0.856 | 184 s | $0.73 | 2026-10-25 | mariusDing | 记录 |
| 9 | Claude Code 2.1.310 种子 778572209 | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort high | 0.86 | 0.39 | 1.00 | 0.54 | 0.698 | 0.564 | 369 s | $0.32 | 2026-10-25 | mariusDing | 记录 |
| 10 | Claude Code 2.1.310 种子 406013493 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.93 | 0.58 | 0.82 | 0.00 | 0.583 | 0.426 | 16 s | $0.06 | 2026-10-25 | mariusDing | 记录 |
| 11 | Claude Code 2.1.310 种子 956466926 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.91 | 0.31 | 0.80 | 0.00 | 0.504 | 0.413 | 19 s | $0.07 | 2026-10-25 | mariusDing | 记录 |
| 12 | Claude Code 2.1.310 种子 166697672 | claude-haiku-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; default effort | 0.50 | 0.46 | 0.25 | 0.56 | 0.440 | 0.198 | 96 s | $0.06 | 2026-10-25 | mariusDing | 记录 |
| 13 | Ollama 0.40.10 种子 792092586 | qwen3-vl:4b-instruct-q4_K_M | frames track; OpenAI-compatible chat completions on Ollama 0.40.10, weights Q4_K_M, 4.0B; one request per task (4 requests, 11-30 contact sheets each as base64 JPEG, sheets as drawn (1280 px on the longer side)), the task's section of TASKS.md and the rules in the prompt, no full-size stills, no tools; temperature 0, max_tokens 4096; server: OLLAMA_CONTEXT_LENGTH=40960, flash attention, KV cache q8_0; RTX 3070 8 GB | 0.00 | 0.31 | 0.00 | 0.00 | 0.077 | 0.000 | 621 s | - | 2026-10-25 | mariusDing | 记录 |
| 14 | Claude Code 2.1.310 种子 280902796 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort max | 0.00 | 0.00 | 0.00 | 0.00 | 0.000 | 0.000 | 1200 s | - | 2026-10-25 | mariusDing | 记录 |
| 15 | Claude Code 2.1.310 种子 604284533 | claude-sonnet-5-5 | frames track; claude -p --restricted --safe-mode --tools Read; effort max | 0.00 | 0.00 | 0.00 | 0.00 | 0.000 | 0.000 | 2401 s | - | 2026-10-25 | mariusDing | 记录 |
每道题 0 到 1 分;总分 = 平均值。按总分排序,同分时日期早的在前。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 用时 = 这次运行实际花的秒数;费用 = agent 自己报告的美元数(Claude Code 会报,Codex 不报);'-' = 没有记录。 原始文件:benchmark/results。
每个参赛者错在哪里
逐题列出每次参赛运行:真实值(来自套件)、结果文件里存的回答、由两者重新算出的分数,以及漏了什么。盲猜基线不列出。时间点:没在 0.5 s 内答中的事件,偏差在 2 s 以内仍能拿部分分;对不上的回答是指 0.5 s 内没有任何事件与它对应。
juggle-touches次数 · count
真实值: 按每次运行自己的种子生成;见各行
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-haiku-5-5 第 1 次(种子 166697672) | 60 | 0.50 | 真实值 40;多了 20 |
| claude-haiku-5-5 第 2 次(种子 778572209) | 50 | 0.86 | 真实值 44;多了 6 |
| claude-opus-5-5 第 1 次(种子 205159368) | 44 | 0.98 | 真实值 45;少了 1 |
| claude-opus-5-5 第 2 次(种子 613104018) | 41 | 1.00 | 真实值 41;完全正确 |
| claude-opus-5-5 第 3 次(种子 959964891) | 42 | 0.98 | 真实值 41;多了 1 |
| claude-sonnet-5-5 第 1 次(种子 208632171) | 50 | 0.98 | 真实值 49;多了 1 |
| claude-sonnet-5-5 第 2 次(种子 280902796) | - | 0.00 | 真实值 49;没有作答 |
| claude-sonnet-5-5 第 3 次(种子 288038083) | 56 | 0.67 | 真实值 42;多了 14 |
| claude-sonnet-5-5 第 4 次(种子 395804731) | 45 | 0.98 | 真实值 44;多了 1 |
| claude-sonnet-5-5 第 5 次(种子 406013493) | 48 | 0.93 | 真实值 45;多了 3 |
| claude-sonnet-5-5 第 6 次(种子 604284533) | - | 0.00 | 真实值 48;没有作答 |
| claude-sonnet-5-5 第 7 次(种子 633675701) | 60 | 0.50 | 真实值 40;多了 20 |
| claude-sonnet-5-5 第 8 次(种子 956466926) | 38 | 0.91 | 真实值 42;少了 4 |
| gpt-6-astra(种子 911623366) | 47 | 1.00 | 真实值 47;完全正确 |
| qwen3-vl:4b-instruct-q4_K_M(种子 792092586) | 100 | 0.00 | 真实值 50;多了 50 |
far-hoop-shots结果 · outcomes
真实值: 按每次运行自己的种子生成;见各行
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-haiku-5-5 第 1 次(种子 166697672) | 进 4,不进 7 | 0.46 | 真实值 进 6,不进 5: x M x M M M M M x x x(M = 进);11 个中错 6 个(第 2 个答成 missed,第 3 个答成 made,第 4 个答成 missed,第 6 个答成 missed 等,另有 2 个) |
| claude-haiku-5-5 第 2 次(种子 778572209) | 进 4,不进 9 | 0.39 | 真实值 进 4,不进 9: x x M x x M M x x x x M x(M = 进);13 个中错 8 个(第 3 个答成 missed,第 4 个答成 made,第 6 个答成 missed,第 7 个答成 missed 等,另有 4 个) |
| claude-opus-5-5 第 1 次(种子 205159368) | 进 4,不进 7 | 1.00 | 真实值 进 4,不进 7: M M x M x x x x M x x(M = 进);完全正确 |
| claude-opus-5-5 第 2 次(种子 613104018) | 进 5,不进 6 | 1.00 | 真实值 进 5,不进 6: x x M M x x M M x M x(M = 进);完全正确 |
| claude-opus-5-5 第 3 次(种子 959964891) | 进 8,不进 5 | 0.54 | 真实值 进 6,不进 7: M M x M x x x x M x x M M(M = 进);13 个中错 6 个(第 2 个答成 missed,第 3 个答成 made,第 6 个答成 made,第 8 个答成 made 等,另有 2 个) |
| claude-sonnet-5-5 第 1 次(种子 208632171) | 进 5,不进 8 | 1.00 | 真实值 进 5,不进 8: x M x x x x M x M x x M M(M = 进);完全正确 |
| claude-sonnet-5-5 第 2 次(种子 280902796) | - | 0.00 | 真实值 进 8,不进 5: M M x x M x x M M M M x M(M = 进);没有作答 |
| claude-sonnet-5-5 第 3 次(种子 288038083) | 进 7,不进 6 | 1.00 | 真实值 进 7,不进 6: x M M M M x x x M M M x x(M = 进);完全正确 |
| claude-sonnet-5-5 第 4 次(种子 395804731) | 进 7,不进 5 | 1.00 | 真实值 进 7,不进 5: M x x M M M M M x x x M(M = 进);完全正确 |
| claude-sonnet-5-5 第 5 次(种子 406013493) | 进 6,不进 6 | 0.58 | 真实值 进 5,不进 7: M M M x x x x x M M x x(M = 进);12 个中错 5 个(第 2 个答成 missed,第 5 个答成 made,第 7 个答成 made,第 10 个答成 missed 等,另有 1 个) |
| claude-sonnet-5-5 第 6 次(种子 604284533) | - | 0.00 | 真实值 进 5,不进 7: M M M x x M x x x x x M(M = 进);没有作答 |
| claude-sonnet-5-5 第 7 次(种子 633675701) | 进 6,不进 7 | 1.00 | 真实值 进 6,不进 7: x M M x x x M M x M x x M(M = 进);完全正确 |
| claude-sonnet-5-5 第 8 次(种子 956466926) | 进 7,不进 6 | 0.31 | 真实值 进 4,不进 9: x M x x x x x M M x M x x(M = 进);13 个中错 9 个(第 1 个答成 made,第 2 个答成 missed,第 3 个答成 made,第 5 个答成 made 等,另有 5 个) |
| gpt-6-astra(种子 911623366) | 进 6,不进 7 | 1.00 | 真实值 进 6,不进 7: x M x M M x M M x x x M x(M = 进);完全正确 |
| qwen3-vl:4b-instruct-q4_K_M(种子 792092586) | 进 7,不进 6 | 0.31 | 真实值 进 8,不进 5: x M x M M M x M M x x M M(M = 进);13 个中错 9 个(第 1 个答成 made,第 2 个答成 missed,第 3 个答成 made,第 4 个答成 missed 等,另有 5 个) |
pass-releases时间点 · timestamps
真实值: 按每次运行自己的种子生成;见各行
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-haiku-5-5 第 1 次(种子 166697672) | 3 次 | 0.25 | 真实值 12 次: 0.72, 2.24, 3.32, 4, 5.6, 6.8, 7.96, 10.56, 12.56, 14.44, 16.88, 18.8 s;12 个中有 9 个不在 0.5 s 内(在 2.24 s,4 s,5.6 s,6.8 s 等,另有 5 个) |
| claude-haiku-5-5 第 2 次(种子 778572209) | 12 次 | 1.00 | 真实值 12 次: 1.88, 2.68, 3.76, 5.56, 7.28, 9.76, 10.96, 12.8, 14.12, 16.04, 16.72, 18.8 s;全部在 0.5 s 内 |
| claude-opus-5-5 第 1 次(种子 205159368) | 11 次 | 1.00 | 真实值 11 次: 0.4, 1.08, 2.84, 5.4, 7.72, 10.4, 11.52, 12.2, 13.6, 15.2, 17.32 s;全部在 0.5 s 内 |
| claude-opus-5-5 第 2 次(种子 613104018) | 11 次 | 1.00 | 真实值 11 次: 1.4, 3.16, 5.64, 6.84, 8.88, 9.56, 11.4, 13.24, 15.56, 17.56, 19.24 s;全部在 0.5 s 内 |
| claude-opus-5-5 第 3 次(种子 959964891) | 12 次 | 1.00 | 真实值 12 次: 1.2, 3.88, 5.84, 7.6, 8.28, 10.64, 12.32, 14.28, 15.08, 16.88, 18.08, 19.6 s;全部在 0.5 s 内 |
| claude-sonnet-5-5 第 1 次(种子 208632171) | 11 次 | 1.00 | 真实值 11 次: 0.76, 1.96, 3.8, 5.88, 8.4, 9.88, 11.48, 13.92, 15.6, 16.28, 18.72 s;全部在 0.5 s 内 |
| claude-sonnet-5-5 第 2 次(种子 280902796) | - | 0.00 | 真实值 11 次: 1, 3.08, 5.92, 7.12, 9.24, 11.4, 12.8, 13.88, 14.96, 16.76, 19.16 s;没有作答 |
| claude-sonnet-5-5 第 3 次(种子 288038083) | 12 次 | 1.00 | 真实值 12 次: 0.52, 2.4, 4.2, 6.12, 7.28, 9.04, 10.28, 12, 12.68, 14.52, 16.4, 18.36 s;全部在 0.5 s 内 |
| claude-sonnet-5-5 第 4 次(种子 395804731) | 11 次 | 0.92 | 真实值 12 次: 0.56, 1.36, 2.84, 3.52, 5.76, 7.72, 9.48, 10.88, 11.56, 13.68, 15.08, 16.68 s;12 个中有 1 个不在 0.5 s 内(在 1.36 s) |
| claude-sonnet-5-5 第 5 次(种子 406013493) | 10 次 | 0.82 | 真实值 11 次: 0.4, 1.6, 3.48, 5.72, 7.4, 9.92, 12.4, 14.44, 16.04, 17.24, 19.04 s;11 个中有 6 个不在 0.5 s 内(在 1.6 s,3.48 s,5.72 s,7.4 s 等,另有 2 个);5 个对不上(在 2.4 s,4.4 s,6.4 s,8.4 s 等,另有 1 个) |
| claude-sonnet-5-5 第 6 次(种子 604284533) | - | 0.00 | 真实值 12 次: 0.6, 2.24, 2.92, 4.2, 5.4, 7.72, 8.4, 10.24, 12.16, 14.8, 16.68, 19 s;没有作答 |
| claude-sonnet-5-5 第 7 次(种子 633675701) | 12 次 | 1.00 | 真实值 12 次: 0.76, 1.44, 3.2, 4.8, 5.48, 7.36, 8.96, 10.92, 12.76, 15.08, 17.04, 18.92 s;全部在 0.5 s 内 |
| claude-sonnet-5-5 第 8 次(种子 956466926) | 11 次 | 0.80 | 真实值 11 次: 0.8, 2, 4.2, 4.88, 7.04, 8.76, 10.44, 12.4, 14.12, 16.08, 19.04 s;11 个中有 8 个不在 0.5 s 内(在 2 s,4.88 s,7.04 s,8.76 s 等,另有 4 个);8 个对不上(在 2.6 s,6.2 s,8 s,9.8 s 等,另有 4 个) |
| gpt-6-astra(种子 911623366) | 11 次 | 1.00 | 真实值 11 次: 1.6, 3.28, 5.56, 7.88, 9.16, 10.6, 12.92, 14.12, 15.64, 16.92, 18.36 s;全部在 0.5 s 内 |
| qwen3-vl:4b-instruct-q4_K_M(种子 792092586) | - | 0.00 | 真实值 11 次: 1.52, 3.6, 4.28, 6, 6.68, 7.8, 9.28, 11.28, 12.56, 13.76, 15.92 s;没有作答 |
stroke-rate比率 · rate
真实值: 按每次运行自己的种子生成;见各行
| 运行 | 回答 | 得分 | 漏在哪里 |
|---|---|---|---|
| claude-haiku-5-5 第 1 次(种子 166697672) | 30 | 0.56 | 真实值 33.333;偏低 10.0% |
| claude-haiku-5-5 第 2 次(种子 778572209) | 40 | 0.54 | 真实值 36.29;偏高 10.2% |
| claude-opus-5-5 第 1 次(种子 205159368) | 33.1 | 1.00 | 真实值 33.149;偏低 0.1% |
| claude-opus-5-5 第 2 次(种子 613104018) | 35.1 | 1.00 | 真实值 35.156;偏低 0.2% |
| claude-opus-5-5 第 3 次(种子 959964891) | 33 | 1.00 | 真实值 32.698;偏高 0.9% |
| claude-sonnet-5-5 第 1 次(种子 208632171) | 33 | 1.00 | 真实值 32.967;偏高 0.1% |
| claude-sonnet-5-5 第 2 次(种子 280902796) | - | 0.00 | 真实值 34.884;没有作答 |
| claude-sonnet-5-5 第 3 次(种子 288038083) | 37.5 | 1.00 | 真实值 37.5;完全正确 |
| claude-sonnet-5-5 第 4 次(种子 395804731) | 37 | 1.00 | 真实值 36.29;偏高 2.0% |
| claude-sonnet-5-5 第 5 次(种子 406013493) | 28 | 0.00 | 真实值 36.388;偏低 23.1% |
| claude-sonnet-5-5 第 6 次(种子 604284533) | - | 0.00 | 真实值 35.62;没有作答 |
| claude-sonnet-5-5 第 7 次(种子 633675701) | 34 | 1.00 | 真实值 34.704;偏低 2.0% |
| claude-sonnet-5-5 第 8 次(种子 956466926) | 28 | 0.00 | 真实值 36.388;偏低 23.1% |
| gpt-6-astra(种子 911623366) | 37.3 | 1.00 | 真实值 37.19;偏高 0.3% |
| qwen3-vl:4b-instruct-q4_K_M(种子 792092586) | - | 0.00 | 真实值 35.433;没有作答 |
svc-bench-1
四段很短的程序画视频,固定机位。
这个套件还没有运行记录。
方法
题目是工具画出来的合成视频,所以真实值是精确的:没有人工标注,也没有评审模型。
agent 只看得到视频,写下回答;bench score 把回答和真实值比对。
完整提示词
bench run 发送的原文,一字不改(以 svc-bench-3 为例;其他套件只改套件名和视频数量)。每个赛道一段文本,所有模型相同。提示词是英文的,这里照原样展示。
代码赛道
You are a contender in a sports film review benchmark (suite svc-bench-3). The current folder holds 4 short videos, TASKS.md and answers.json. Read TASKS.md and follow its rules exactly: watch the videos (frames, ffmpeg, OpenCV or any script you write on the video files in this folder), then replace each null in answers.json with your answer in the stated format. Do not read the sports-video-coach package source, its git history, or any truth or result file anywhere on this machine. Work only inside this folder (temporary files under this folder are fine). Work alone, do not ask questions, and finish when answers.json is filled and parses as JSON. End with one line per task: your answer and how you got it.静帧赛道(Claude Code)
You are a contender in a sports film review benchmark (suite svc-bench-3, frames track). This track measures how well you review film by eye: you get still images of 4 short videos and no way to run code. Judge by looking only. Do not try to read anything outside the given images and task text, and do not start helpers or sub-agents. Work alone, do not ask questions. End your reply with the whole answers.json (keys suite, track, answers; replace each null with your answer in the stated format) in one ```json block, after one line per task: your answer and how you got it. The current folder holds TASKS.md, answers.json and the images (contact sheets in sheets/, full-size stills in frames/). Your only tool is Read: read TASKS.md first, then the images it lists.Claude Code 静帧那几行用的就是这段静帧提示词。其他行的结果文件没有存提示词,所以它们用的是什么不清楚。
次数 count
多少次颠球、拍球或投篮。
1 - |误差| / 真实值,最低为 0。
比率 rate
节奏或百分比。
与真实值相差 2 % 以内得 1,线性下降,到 20 % 时为 0。
时间点 timestamps
每个事件发生在什么时候。
每个事件:0.5 s 以内得 1,到 2 s 线性降为 0,漏掉得 0;求和后除以真实值和回答两个列表中较长的那个,所以多报的事件也扣分。
结果 outcomes
进还是没进,按顺序。
按位置答对的比例。
总分 = 各题分数的平均值。超出盲猜:每道题算 (score - floor) / (1 - floor),限制在 0..1;floor 是盲猜基线的分数(它照抄题目里的示例答案,不看视频)。0 = 不比这种瞎猜强,1 = 满分。 完整规则:docs/benchmark.md(英文)。
自己跑一遍
- 安装(需要 PATH 上有 ffmpeg)
uv tool install git+https://github.com/mariusDing/sports-video-coach@74b517fc410944fefeac2979810656ed77fb8f1a - 生成题目:视频和一个空的 answers.json(最新的套件;去掉 --suite 就是 svc-bench-1)
sports-video-coach bench prepare --out bench-run --suite svc-bench-3 - 让你的 agent 看视频、填好 bench-run/answers.json,然后打分
sports-video-coach bench score bench-run --agent "Your agent" --model "your-model" - 或者一条命令全做完(准备、无界面运行、打分):Claude Code 或 Codex
或者用其他 agent CLI 的预设。这些预设按各 CLI 的文档写成(2026-10-25 读过),参数在 2026-10-25 对照真实 CLI 的 --help 核对过,但维护者没有用它们实际跑过题目(OpenCode 除外:OpenCode 1.19.4, opencode/deepseek-v4.1-flash-free, 2026-10-25,跑过一次);只支持代码赛道(每个参数的文档链接)。其他 CLI:sports-video-coach bench run --agent claude --suite svc-bench-3 sports-video-coach bench run --agent codex --suite svc-bench-3--agent cmd --cmd "... {prompt}"。--agent geminiGemini CLI:gemini --approval-mode yolo [--model M] -p <prompt>(参数已对照 0.65.0 的 --help 核对)--agent qwenQwen Code:qwen --safe-mode --approval-mode yolo [--model M] <prompt>(参数已对照 0.26.1 的 --help 核对)--agent aiderAider:aider --yes-always --no-git --no-check-update --no-pretty --no-stream [--model M] --read TASKS.md --message-file <prompt file> answers.json(参数已对照 0.86.2 的 --help 核对)--agent opencodeOpenCode:opencode run --auto --print-logs --log-level ERROR --dir <run folder> [--model M] <prompt>(参数已对照 1.19.4 的 --help 核对)--agent cursorCursor CLI:agent -p --force --trust --output-format text [--model M] <prompt>(参数已对照 2026.10.22-27dcf5f 的 --help 核对)--agent copilotGitHub Copilot CLI:copilot -p <prompt> --allow-all-tools --no-ask-user -s [--model M](参数已对照 1.0.103 的 --help 核对)--agent gooseGoose:goose run --no-session [--model M] -t <prompt>(参数已对照 1.56.0 的 --help 核对)
提交你的运行
- 开一个 pull request,把你的结果文件加到
benchmark/results/。 CI 会用bench validate重新打分。 你的第一个 PR 的检查要等维护者批准后才会运行。 - 不想开 pull request?把文件贴进基准结果 issue 表单。
- 规则:不读真实值文件,不读包的源码;一次运行 = 一个文件;如实报告实际用时。
诚实说明
- 这个基准测试和本页都是用编程 agent(Claude Code)做的,中文版也是。
- 每一行都能重跑:同样的套件、同样的命令,分数由存下的回答重新算出。重跑的回答可能不同(见页首的样本量说明)。
- 作者写了这个工具、画了套件、提交了最早的几次运行;欢迎外部提交(见上文)。
- 失败和被终止的运行留在榜上,计入该参赛者的平均分。
- 合成训练题测的是数数和计时,不是教练复盘的全部。